2023 年,澳大利亚悉尼。来自新西兰的 Micah Hill-Smith 在悉尼的麦肯锡做过五年咨询顾问,这时正在做一个法律方向的 AI 研究助手。产品越做越深,他发现自己每天都在回答同样几个问题:这一步该用哪个模型?同一个模型,哪家 API 服务商更快、更便宜?厂商公布的成绩到底能不能信?他后来在 Latent Space 播客里回忆,用大模型做产品,做到最后,每一步都会变成一个评测问题。
他去找现成的答案,却没有找到。当时没有人在系统、独立地评测大模型,厂商公布的成绩往往用的是对自己最有利的测试方法。那年 12 月,Google 发布 Gemini 1.0 Ultra,宣布它在 MMLU 上超过了 GPT-4。可仔细一看,Gemini 用的是 32 次采样加思维链的方式,而用来对比的 GPT-4 成绩用的是另一种测法。
Micah 和在旧金山的澳大利亚人 George Cameron 决定自己动手。George 之前也在做战略咨询,主要服务数据中心和科技公司。两人利用业余时间搭了一个网站,取名 Artificial Analysis。2024 年 1 月,网站上线,最初的功能非常简单:把同一个模型在不同 API 服务商那里的速度和价格放在一起比较。不久之后,网站在 Latent Space 播客里被提到,开发者们发现这正是他们需要的东西,它很快就受到了关注。
2024 年 7 月,吴恩达在 X 上专门点名称赞:这个网站为不同 LLM API 服务商的速度做了评测,能帮助开发者选择模型。这条推文有 120 万次浏览,Lex Fridman 也在下面留言说“很好用”。Latent Space 的主持人 swyx 后来也成了它的投资人之一。
之后的事情发展得很快。两人加入了 Nat Friedman 和 Daniel Gross 主持的 AI Grant 项目,公司从悉尼搬到了旧金山,投资人名单里还有吴恩达。他们给自己定了一条规矩:没有人能花钱买到榜单上的位置。公开榜单免费,收入来自向企业出售评测报告订阅,以及为 AI 公司做定制化的私有评测。为了防止厂商对评测账号区别对待,他们用非公司域名注册账号,匿名调用各家的 API,他们自己把这称为“神秘顾客”策略。到 2025 年底,这家公司也只有大约 20 个人。
真正让它成为行业焦点的,是后来推出的“智能指数”(Intelligence Index)。2025 年的版本,主要是把 MMLU-Pro、GPQA、HLE、LiveCodeBench、SciCode、AIME 这些主流学术 benchmark 用统一的方法重新跑一遍,再合成一个总分。这样一来,各家模型的成绩第一次可以在同样的条件下比较。之后的第三版加入了 Terminal-Bench 和客服类的智能体任务;2026 年 1 月的第四版又加入了 GDPval-AA、AA-Omniscience、CritPt 等新评测,把整个指数重新划分为智能体、编程、通用、科学推理四大类。此后指数更新得越来越频繁:6 月发布了 v4.1,9 月 4 日发布了 v4.2,仅仅三天后的 9 月 7 日,又发布了 v4.3。到今年 9 月,这份指数已经覆盖了 600 多个模型。
从悉尼的一个业余项目,到全行业都在关注的排行榜,Artificial Analysis 只用了不到三年。
谁在决定大模型的第一名?
这一年多来,几乎每一次大模型发布,你都会注意到同一个细节:发布材料里一定会出现 Artificial Analysis 的数字。xAI 在 8 月发布 Grok 4.6 时,把当时的 Artificial Analysis 智能指数 61 分直接列进了自家的成绩表;智谱 GLM-5.3 在 8 月发布后不久,就以 45 分成为 Artificial Analysis 新版指数上得分最高的开放权重模型;小米 9 月发布 MiMo-V2.6-Pro,媒体报道的核心是它以 46 分登上了这份榜单的开放权重第一;Kimi K3 在 7 月发布时,最常被转述的一句话是“Artificial Analysis 智能指数全球第三”。即使是 Anthropic 和 Google,也会在发布表里引用由 Artificial Analysis 运行的 GDPval-AA 成绩。
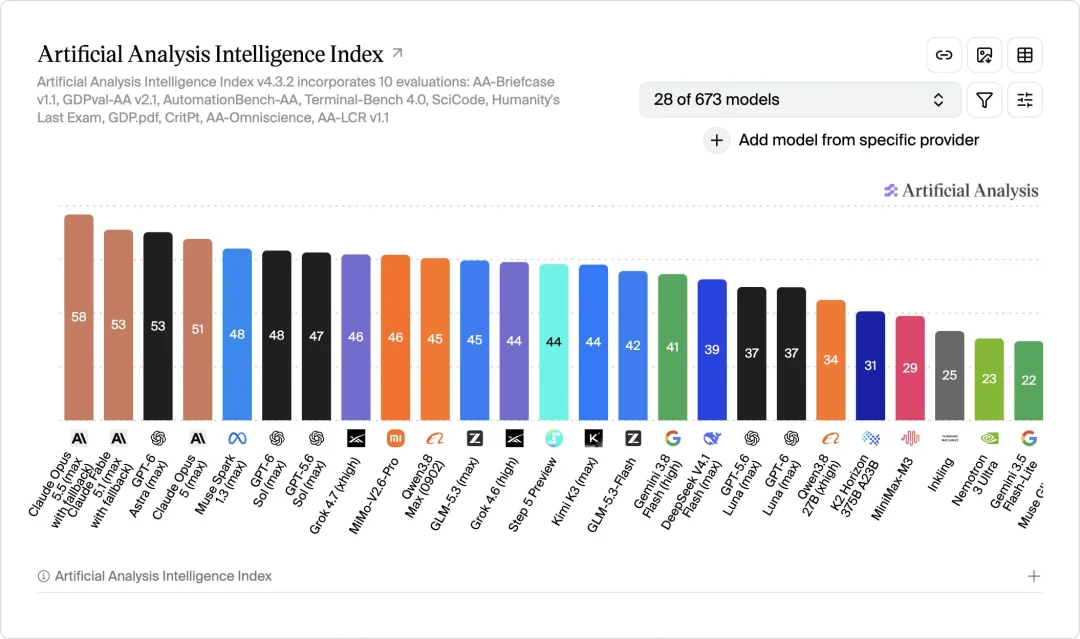
我的直观感受是:今天一个新模型发布,如果不能在 Artificial Analysis 上明显超过自己的上一代,或者超过同期的友商,这次发布在舆论上几乎就没有什么声量。一家成立不到三年的独立评测机构,已经成了全行业发布新模型时绕不开的一环。
这件事本身并没有什么。但它也带来一个新问题:当所有人都在争同一份榜单上的第一名,我们有没有认真想过,这份榜单是怎么算出来的,它能反映什么,又反映不了什么?厂商自己公布的那些成绩,又是按照什么逻辑挑选出来的?
要回答这些问题,得先把 benchmark 这件事本身讲清楚:它们是怎么做出来的,各自测什么,厂商在发布时会挑选哪些成绩,第三方榜单又是怎么算出一个总分的。只有明白了这些,才能理解为什么分数和实际体验之间会出现差距。
一、常见的几类 benchmark,分别在测什么
Benchmark 的本意很朴素:找一批有标准答案,或者有明确判定规则的任务,让模型去做,统计做对了多少。难点在于找什么样的任务。任务不同,测到的就是完全不同的能力。这几年行业里的主流 benchmark,大致经历了从考知识,到考写代码,再到考完成一项完整工作的变化。下面挑几个最常被引用的,逐一介绍。
MMLU 和 GPQA:以知识题为主的阶段。MMLU 出现于 2020 年,覆盖 57 个学科的一万多道多项选择题,从高中数学到法律、医学都有。它曾经是衡量模型知识面的标准测试,但前沿模型的得分早已接近满分,现在基本没有厂商再把它放进发布表。GPQA Diamond 是难度更高的版本,198 道由博士级专家编写的生物、化学、物理题,出题时要求用搜索引擎也难以直接查到答案。2026 年,前沿模型在 GPQA 上普遍超过 90%,它也在逐渐失去区分度。这类测试擅长衡量知识储备和单步推理,但完全不涉及模型能否动手完成任务。
HLE(Humanity’s Last Exam):难度推到极限的学术题。HLE 由 Center for AI Safety 和 Scale AI 在 2025 年 1 月发布,面向全球学者征题,最终收录了 2,500 道题,覆盖数学、人文、自然科学等一百多个学科。每道题都必须能难住当时最强的模型才会被收录。为了征集高质量题目,主办方设立了 50 万美元的奖金:排名前 50 的题目每道奖励 5,000 美元,接下来的 500 道每道 500 美元。发布时,最好的模型得分还不到 10%;到 2026 年 9 月,Claude Opus 5.5 在允许使用工具的条件下已经报告了 67.7%。HLE 擅长测量专家级的知识和推理深度,但它的题目大多是有唯一正确答案的难题,和日常工作中那种需要反复试错、没有标准答案的任务差别很大。另外,这样的题目本身也难免出错:2025 年 7 月的一项独立审查发现,HLE 中部分化学和生物题的参考答案有约三成存在问题,此后 HLE 推出了持续修订的版本。
SWE-bench 系列:修复真实代码库中的问题。SWE-bench 由普林斯顿大学的研究者在 2023 年发布,从 12 个流行的 Python 开源项目里收集了 2,294 个真实的 GitHub issue,要求模型读懂代码库、写出修复补丁,再用项目原有的测试检查是否修好。它第一次把写代码从做算法题变成了在真实工程里解决问题。2024 年,OpenAI 与作者合作,请了 93 名专业开发者对题目逐一人工审核,筛出 500 道题意清楚、测试合理的题目,也就是后来被广泛引用的 SWE-bench Verified。
这个系列后来的经历,很能说明 benchmark 的寿命问题。2026 年 2 月,OpenAI 宣布不再报告 SWE-bench Verified:它审查了其中 138 道题,发现 59.4% 的测试用例会把功能上正确的答案判为错误;同时,所有被测的前沿模型都能复述出部分题目的原始解法,说明题目已经进入了训练数据。OpenAI 当时建议行业改用 Scale AI 出品的 SWE-bench Pro。但到了 7 月,OpenAI 又审查了 SWE-bench Pro,发现约 30% 的任务存在问题,于是公开撤回了这项推荐。
DeepSWE:从零编写的代码任务。正是在这个背景下,Datacurve 在 2026 年 5 月发布了 DeepSWE。它的 113 项任务分布在 91 个代码仓库、5 种编程语言中,所有任务都是从零编写的,不改编自任何已有的代码提交,因此不存在模型在训练时见过答案的问题。它的参考解法平均有 668 行代码,是 SWE-bench Pro 的五倍多;所有模型都通过同一个通用代理框架 mini-swe-agent 运行。短短几个月里,它已经成为各家发布表中出现最多的代码类 benchmark。
Terminal-Bench:在命令行里完成多步骤任务。Terminal-Bench 由斯坦福大学和 Laude Institute 在 2025 年发起。它的每一项任务由四部分组成:一段说明要做什么的文字指令,一个预先装好文件和依赖的容器环境,一份证明任务可以完成的参考解法,以及一组最终检查结果的自动测试。模型要在终端里自己读文件、装软件、改配置、运行程序,最后由测试判断是否完成。任务类型也不止写代码,还包括系统运维、数据处理、模型训练、网络安全和科学计算。它测的是连续多步骤的实际操作能力,这也是本文后半部分会重点讨论它的原因。
它的版本更新很快:2.0 版在 2025 年 11 月发布,2.1 版在 2026 年 5 月修复了 2.0 中的 28 项任务,3.0 版在 7 月 30 日发布,包含 74 项全新的、更难的任务,4.0 版在 8 月 28 日发布,在 3.0 的基础上删除了 8 项任务、修复了 19 项,并把每项任务的运行时间上限统一定为 8 小时。
GDPval:用职业工作来衡量模型。GDPval 是 OpenAI 在 2025 年 9 月发布的评测。它从对美国 GDP 贡献最大的 9 个行业里选了 44 种职业,请平均有 14 年以上从业经验的专业人士,根据自己真实做过的工作设计了 1,320 项任务,要求的产出是法律文书、财务报表、工程图纸、护理方案这类实际交付物。评分方式是请同行业的专家在不知道作者身份的情况下,比较模型和人类专家的作品哪个更好。它想回答的是,在有经济价值的知识工作上,模型离人类专家还有多远。
Agents’ Last Exam:面向智能体的高难度职业任务。这是加州大学伯克利分校的 Dawn Song 团队在 2026 年 6 月发布的新评测,名字显然是在向 HLE 致敬。一百多个机构的三百多名专家参与了编写,共有 1,500 多项任务,覆盖美国职业分类中的 55 种非体力职业。每项任务都来自人类专家真实完成过的项目,人类完成它们需要几小时到几周;模型需要在完整的图形界面和命令行环境里工作,最后由客观规则判定成败。发布时,在最难的一档任务上,所有前沿智能体的成功率都是 0,每项任务的运行成本在 1.33 到 15.70 美元之间。
OSWorld:操作电脑。OSWorld 在 2024 年发布,让模型通过截图和鼠标键盘操作真实的电脑系统,完成整理表格、修改设置、跨应用处理文件之类的任务。后续又有了经过人工校验的 OSWorld-Verified 和 2026 年的 OSWorld 2.0。它测的是使用电脑的能力,和写代码是两回事。
Arena:让用户投票。最后一类完全不同。Arena 最早是 2023 年伯克利 LMSYS 团队推出的 Chatbot Arena:用户提一个问题,两个匿名模型各自回答,用户选择更喜欢的那个,平台再把大量两两比较的结果换算成排名。它没有标准答案,测的是用户偏好。第三节会专门讨论它。
把这些测试放在一起看,会发现一个规律:一个 benchmark 从发布到被前沿模型做满,时间越来越短。MMLU 用了三四年,GPQA 两年左右,SWE-bench Verified 发布一年半后就被 OpenAI 放弃,Terminal-Bench 2.x 不到一年就有一批模型超过了 85 分。新 benchmark 的出题速度,已经很难跟上模型进步的速度。
二、Artificial Analysis 的智能指数是怎么算的
介绍完这些常见的 benchmark,再回到文章开头的 Artificial Analysis。它当前的智能指数 v4.3.2 由十项评测组成,分为四个大类,各有权重:
前面已经介绍过 HLE、Terminal-Bench 和 GDPval,下面把其余几项逐一说明。
AA-Briefcase是 Artificial Analysis 自己设计的评测,也是指数中权重最高的一项。它包含 4 个商业场景下的 91 项知识工作任务,模型需要以智能体的方式工作,最多可以进行 500 轮操作,最后交付文件形式的成果。评分由三个模型组成的评审组完成,既按评分细则逐项检查,也对两份成果做两两比较,最后换算成 Elo 分数。题目不公开。
GDPval-AA是 Artificial Analysis 基于 OpenAI 公开的 220 项 GDPval 任务做的自动评分版本。模型在一个预装了 419 个 Python 库和 762 个系统软件包的沙箱里完成任务、生成文件,再由三个模型组成的评审组做匿名两两比较,结果换算成 Elo 分数,并以 DeepSeek V4.1 Flash 的成绩作为 1600 分的基准点。它和原版 GDPval 最大的不同,是用模型评审代替了人类专家评审。
AutomationBench-AA来自 Zapier,测的是跨软件的业务流程自动化。657 项任务分布在财务、人力、市场、运营、销售和客服六个领域,模型要通过 REST API 在模拟的 Gmail、Slack、Salesforce 等应用中完成操作,最后由程序检查各个系统的状态是否正确。如果模型违反了预设的安全规则,这项任务直接记零分。Artificial Analysis 使用的是不公开的测试集。
SciCode由学术团队编写,要求模型用 Python 解决科学计算问题,共 288 个子问题,每个子问题都附有科学家撰写的背景说明,写出的代码必须通过全部单元测试才算正确。
AA-Omniscience是 Artificial Analysis 设计的知识与幻觉测试,包含 6,000 道开放式问答题,覆盖商业、人文、健康、法律、软件、科学等 42 个主题。它的特点是惩罚编造:回答错误会扣分,而在不确定时选择不回答则不会被扣分。最终成绩由准确率和不产生幻觉的比例两部分组成。
GDP.pdf来自 Surge AI,测的是阅读和分析长篇专业文档的能力。100 项任务以 10 个专业领域的 4,592 页 PDF 文档为材料,每项任务都有若干条具体的评分标准,总计 1,275 条,由模型逐条判断是否满足。
AA-LCR是 Artificial Analysis 设计的长上下文推理测试,100 道难题,每道题需要模型阅读约 10 万个 token 的文档后作答,整个测试涉及约 230 份文档、300 万个 token 的输入,要求模型至少支持 12.8 万 token 的上下文窗口。
CritPt是研究级的物理推理测试,70 道题目都是未公开发表的前沿物理问题,答案可以是数值、符号表达式或 Python 函数,由 CritPt 团队的官方评分服务器判定。
各项评测的规模和运行方式差别很大:AA-Omniscience 有 6,000 道题,只跑一次;Terminal-Bench 4.0 有 66 项任务,每项跑三次;CritPt 只有 70 道题,但每道跑五次。整个指数主要基于英文文本任务,多语言、图像和语音能力另有单独的指数;速度和价格也是单独统计的,不计入智能指数。
为什么它的参考价值在下降
首先先说清楚,Artificial Analysis 做的事情很有价值,它的方法说明也比绝大多数厂商的发布材料透明得多。我的看法是:它作为了解行业整体情况的参考依然很好用,但作为“哪个模型最强”的最终判断,参考价值在下降。原因有几个。
其一,指数里由 Artificial Analysis 主导的评测越来越多,其中不少题目不公开。十项评测里,名字带“AA”的已经有五项,其中 AA-Briefcase、AA-Omniscience 和 AA-LCR 三项完全由它自己设计。按 Artificial Analysis 自己的说法,使用私有题目或私有答案的评测在 v4.3 中占到 45% 的权重,比 v4.2 的 40% 还高。私有题库能有效防止厂商针对性训练,这是真实的好处;代价是外部没有办法复核。
当一个指数将近一半的分数来自只有评测方自己能看到的题目时,它更接近一家机构的专业意见,而不是任何人都可以复现的测量结果。
其二,指数的版本变化太快,分数的含义也跟着变。9 月的一周之内指数就更新了两次。每次更新,所有模型的分数都会重新计算:Kimi K3 在 7 月发布时的得分是 57,排名全球第三,在 v4.3.2 下变成了 44;DeepSeek V4 Flash 0731 发布时是 50 分,现在是 34 分。这些模型本身没有任何变化,但是计分方法变了。可是媒体和厂商在传播时,很少会注明是按 v4.2 还是 v4.3 计算的。把 7 月的 57 分和 9 月的 46 分放在一起比较,是没有意义的。
其三,相当一部分评分依赖其他厂商的模型当评委。AA-Briefcase 和 GDPval-AA 由三个模型组成的评审组打分;AA-Omniscience、GDP.pdf、AA-LCR 和 HLE 的答案判定都使用 OpenAI 的 GPT-5.6 Luna。让一家参赛厂商的模型给所有选手打分,不一定会产生偏差,但这至少是一个应该公开讨论的问题。
其四,也是我们最应该在意的一点:综合分会把最有用的信息平均掉。在 Terminal-Bench 4.0 上,GLM-5.3 得分 42%,Kimi K3 是 13%,相差三倍多;但在综合指数上,两者只差 1 分。对于一个正在挑选编程智能体的开发者,这两个模型在这项任务上的差距是决定性的;而对于一个主要做长时间办公类任务的用户,Kimi K3 在 AA-Briefcase 上得到 1505 分,和 GLM-5.3 的 1516 分相差无几,还高于 GPT-5.6 Sol 的 1487 分。
不同的用户,应该看完全不同的子项。一个总分,恰恰把这些差别隐藏了起来。
所以我的建议是,看 Artificial Analysis 的时候,不要只看总榜第一行,而要把你关心的那几个子项单独拿出来看,并且注意它的版本号和日期。
还有一个现象值得行业反思。正是因为所有人都拿 Artificial Analysis 的分数来发布、来宣传,它的指数本身也就成了各家优化的目标。
经济学里有个古德哈特定律:一个指标一旦成为追求的目标,就不再能准确地衡量它原本要衡量的东西。
任何一个被全行业共同使用的评测,迟早都会遇到这个问题,Artificial Analysis 也不例外。它频繁更新版本、提高私有题目的比例,某种程度上也是在应对这个问题。
三、Arena 的排名,是不是就更客观?
和 Artificial Analysis 的思路完全相反,Arena 不设固定题库,而是让真实用户来投票。机制很简单:用户提一个问题,两个匿名模型各给一个回答,用户选自己更满意的那个,平台用 Bradley-Terry 模型把成千上万次比较换算成排名。看不到品牌,就减少了先入为主;问题来自真实用户,也更贴近日常使用。很多人因此认为,Arena 是最客观的榜单。
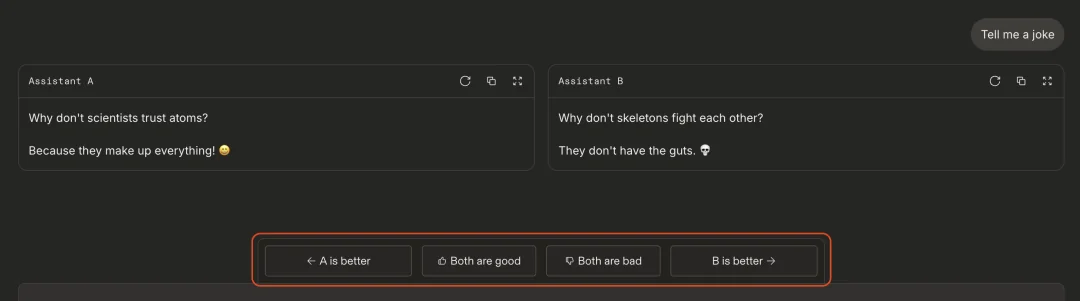
Arena 测到的东西是真实的,也有价值,但它反映的是特定人群在特定问题上的偏好,不应该被理解为客观的能力排名。
首先,偏好会受到与能力无关的因素影响。Arena 自己的研究发现,回答越长、Markdown 格式越丰富、语气越积极,越容易赢得投票。它后来引入了“风格控制”,在计算排名时扣除长度和格式的影响。这项修正本身就说明,未经控制的原始排名里,有一部分是在给写作风格打分。
其次,平台规则会影响结果。2025 年,Cohere 等机构的研究者发表了论文《The Leaderboard Illusion》,指出大厂可以在正式发布前私下测试多个模型变体,最后只公开表现最好的那个。论文举例说,Meta 在发布 Llama 4 之前私下测试了 27 个变体。在此之前,Meta 也承认,在 Arena 上排名很高的 Llama 4 Maverick 是一个“针对对话优化的实验版本”,并不是开发者实际能下载到的版本。论文还估算,头部闭源厂商从平台获得的对战数据远多于开放权重模型。Arena 公开回应,认为论文的部分数据和描述不准确,并强调预发布测试的目的是帮助厂商改进模型;在 Llama 4 事件之后,Arena 也更新了模型上榜的相关规则。
再次,投票者能够判断的东西是有限的。一个普通用户可以很快判断哪个回答读起来更顺、更有条理,却很难判断一段代码能不能在生产环境里跑通,或者一份分析报告里有没有隐蔽的事实错误。
Arena 擅长回答用户更喜欢和哪个模型对话,不擅长回答哪个模型更能把一件复杂的工作做完。
所以,Arena 的排名很适合用来判断一个模型的对话体验,但“真人盲测”这四个字,并不能让它自动变成一个客观、通用的能力排名。
四、各家厂商在发布时公布了哪些 benchmark
看完两家第三方榜单,再来看各家厂商在发布新模型时,自己选择公布哪些成绩。我逐一查阅了本文涉及的 13 家厂商最近一次旗舰模型发布的官方材料,包括发布公告、模型卡和系统卡,把它们报告过的 benchmark 整理成下面这张图。
图分上下两部分。上半部分是多数厂商都会报告的公共项目,下半部分是只有少数厂商报告的自选项目,最下面单独列出各家以自己名字命名或自行设计的评测。Terminal-Bench 的不同版本分别计算。每一部分内部,按采用的厂商数量从多到少排列。
参与统计的模型分别是:OpenAI GPT-6 Astra(9 月),Anthropic Claude Opus 5.5(9 月),Google Gemini 3.8 Flash(9 月),xAI Grok 4.7(9 月),智谱 GLM-5.3(8 月),月之暗面 Kimi K3(7 月),DeepSeek V4 Pro 0813(8 月),阿里 Qwen3.8 Max(8 月,含 9 月的 0902 更新),小米 MiMo-V2.6-Pro(9 月),阶跃星辰 Step 5 Preview(9 月),腾讯 Hy4 preview(8 月),MiniMax-M3(6 月),字节跳动 Seed2.1 Pro(6 月)。
从这张图里能看出几件事:
第一,DeepSWE 在短短四个月里被 10 家厂商采用,排在所有项目的第一位,而曾经每家都会报告的 SWE-bench Verified,现在只有个别厂商还在报告。OpenAI 的两次审查,直接改变了整个行业的选择。
第二,把 Terminal-Bench 的版本拆开之后,差别就很明显了。如果不区分版本,Terminal-Bench 是唯一一个 13 家厂商全部报告过的项目;但 2.1 版有 9 家报告,4.0 版有 6 家,3.0 版只有智谱和阿里两家报告。报告哪个版本,很大程度上由发布时间决定:7 月底之前发布的模型只能报告 2.1;8 月发布的模型已经可以报告 3.0,但多数仍然只报告了 2.1;9 月发布的模型开始报告 4.0。
第三,中美厂商常用的公共项目并不完全一样。Toolathlon 和 ProgramBench 几乎只出现在国内厂商的发布表里,而 FrontierCode、CursorBench、Terminal-Bench-Science 则主要出现在美国厂商的表里。这在一定程度上反映了各家的比较对象:国内厂商之间互相比较得更多,也更倾向于选择彼此都报告过的测试。
第四,国内厂商中,小米和智谱的发布表覆盖面最广。上半部分的 12 个公共项目中,MiMo-V2.6-Pro 报告了 10 个,GLM-5.3 报告了 9 个,而智谱还是在 Terminal-Bench 3.0 刚发布时就把它写进发布表的两家之一。一份发布表愿意覆盖多少公共项目,某种程度上也反映了厂商对自己模型在横向比较中的信心。
第五,自选项目和自建评测非常普遍,几乎每家都有。OpenAI 报告 ARC-AGI 和 FrontierMath,Google 报告法律和生物研究类评测,xAI 报告电气工程和医疗评测,Kimi 报告了一整组搜索与工具调用评测,小米和字节各有三项以自家名字命名或自行设计的评测。这本身无可厚非,厂商最清楚自己的模型想在哪些方向上发力,也需要有自己的评测来指导研发。但读者需要明白:一项只有一家厂商报告、题目和评分规则又由这家厂商自己决定的成绩,它的意义和公共项目上的成绩是不一样的。前者告诉你的是厂商重视什么,后者才可以横向比较。
五、国产开放权重模型:谁是第一,要看在哪个项目上
几个“开源第一”
2026 年夏天,国产开放权重模型的竞争非常激烈,“开源第一”的说法在几个月里出现了好几次,而且每一次都有它的依据。
7 月 16 日,月之暗面发布 Kimi K3。这是发布时参数规模最大的开放权重模型,总参数 2.8 万亿,上下文长度 100 万。它在自家发布表中,在 BrowseComp(91.2)、DeepSearchQA(95.0)、MCPMark(94.5)等搜索和工具调用评测上都是表中最高分,在 SWE-Marathon 这类超长时程编程任务上也超过了 Claude Fable 5 和 GPT-5.6 Sol。Artificial Analysis 在它发布时还专门提到,它在 AutomationBench 上排名第一,完成每项任务的平均成本和 GPT-5.6 Sol 相当,大约是 Opus 4.8 的一半。
8 月,智谱发布 GLM-5.3。在 Artificial Analysis 随后的 v4.3 指数中,它以 45 分排在开放权重模型第一。GLM-5.3 在同一个基座模型上只靠扩大后训练规模,就把 Terminal-Bench 3.0 的成绩从上一代的 4.6% 提高到 28.3%,把 DeepSWE 从 46.2% 提高到 66.9%。它在 Artificial Analysis 测试的 AutomationBench 上得到 62%,高于 GPT-5.6 Sol 的 60% 和 Claude Opus 5 的 57%。智谱还披露,在开发过程中,GLM-5.3 在 269 个开源项目中发现了 2,436 个安全漏洞,并通过公开台账向项目方披露。8 月底发布的 GLM-5.3-Flash 采用 MIT 许可证,总参数 3,200 亿、激活参数 180 亿,在 Artificial Analysis 指数上得到 42 分,每百万输入 token 的价格只有 0.15 美元。
同样在 8 月,DeepSeek 发布了 V4 Pro 0813,并以 MIT 许可证开放了模型权重,这是这批模型中最宽松的授权方式之一。它在自己的发布表里报告了 Terminal-Bench 2.1 的 87.9%,超过 Claude Opus 4.8 的 85.0%;在 CyberGym 安全评测上是 83.3%,同样高于 Opus 4.8。更早的 DeepSeek V4 Flash 0731 体现了 DeepSeek 一贯的工程风格:总参数 2,840 亿,每次推理只激活 130 亿参数,Artificial Analysis 测得它的输出速度是每秒 211 个 token,是 GPT-5.6 Luna 的 1.7 倍,首个 token 的延迟只有 1.15 秒。
9 月 21 日,小米发布 MiMo-V2.6-Pro,同样采用 MIT 许可证。它在 Artificial Analysis 指数上以 46 分超过 GLM-5.3 一分,成为新的开放权重第一。小米在发布表里同时公布了 Terminal-Bench 2.1(89.9%)和 4.0(34.9%)两个版本的成绩,并没有只挑对自己最有利的那个。
从这几个例子可以看出,“开源第一”至少有三层含义需要说清楚。一是按哪个榜单、哪个版本计算,第一和第三之间往往只差一两分,而指数本身每隔几周就会重新计算。二是开放到什么程度,MIT 许可证和厂商自定义的许可证在商用、修改上的限制是不一样的。三是在哪些能力上领先:Kimi K3 在搜索、工具调用和长时间办公类任务上的优势,DeepSeek 在推理效率和开放授权上的优势,GLM-5.3 在终端任务和业务流程自动化上的表现,本来就是不同方向上的第一。
Terminal-Bench 版本更新后的变化
这几个模型在 Terminal-Bench 2.1 上的成绩非常接近。按各家发布时自己报告的数字,MiMo-V2.6-Pro 是 89.9%,Kimi K3 是 88.3%,GLM-5.3 是 88.2%,DeepSeek V4 Pro 0813 是 87.9%;同期的 GPT-5.6 Sol 是 88.8%,Claude Opus 5 是 89.1%。前沿模型全部集中在 88% 到 90% 之间,彼此相差不到两个百分点。
9 月 7 日,Artificial Analysis 把指数中的 Terminal-Bench 从 2.1 升级到 4.0,所有模型都用同一个代理框架 mini-swe-agent 重新测试,结果差别就大了。
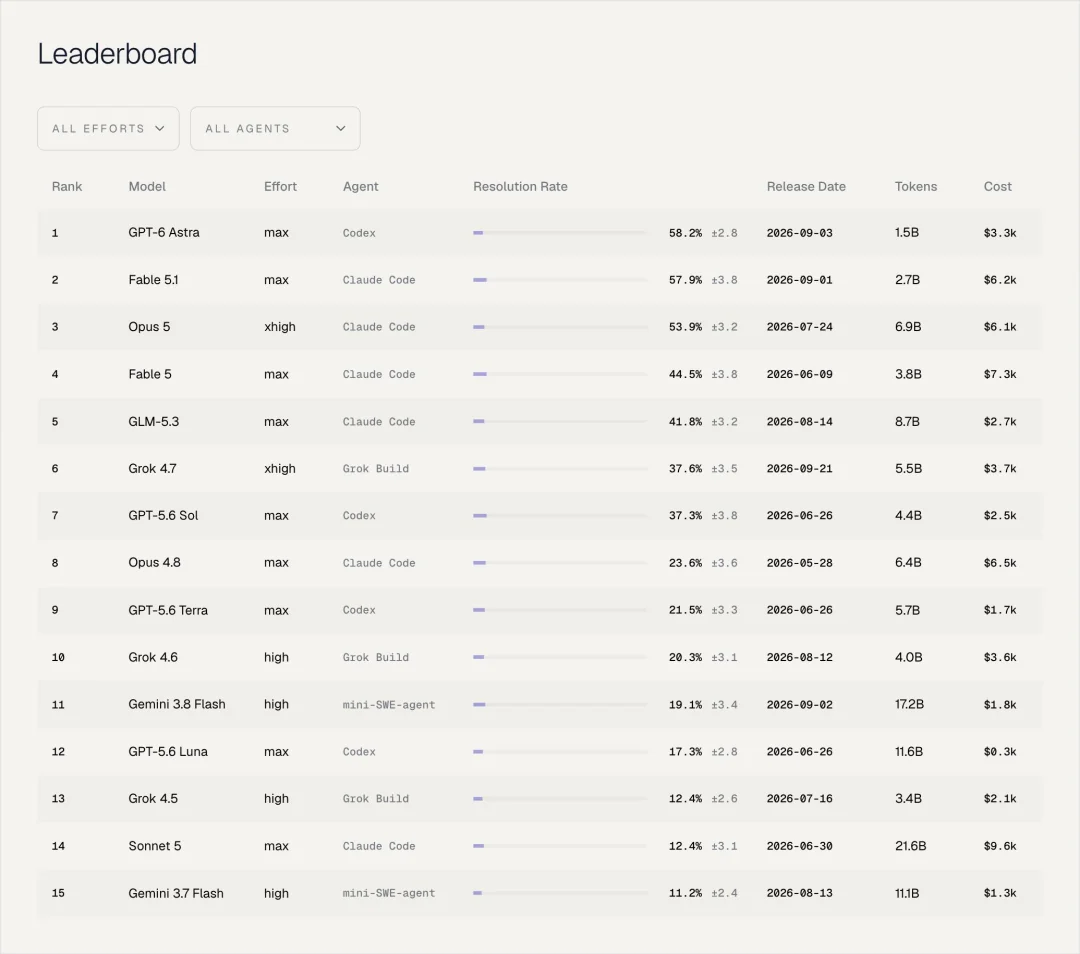
4.0 比 2.1 难得多,所有模型的分数都大幅下降,这在意料之中。真正有信息量的是相对位置的变化。在 4.0 上,GLM-5.3 是表现最好的开放权重模型,和 Claude Fable 5 持平,高于 GPT-5.6 Sol;Qwen3.8 Max 和 MiMo-V2.6-Pro 也和 Claude、GPT 的上一代旗舰处在同一水平;而 DeepSeek V4 Pro 和 Kimi K3 的分数明显偏低。在 Snorkel AI 维护的 Terminal-Bench 4.0 榜单上,GLM-5.3 搭配 Claude Code 框架测出 41.8%,与 Artificial Analysis 的结果基本一致,也是这份榜单前十名中唯一的开放权重模型。两家机构用不同的框架测出几乎相同的成绩,说明 GLM-5.3 的表现不太依赖某一种特定的测试条件。
所以,“国产模型在新版本上整体下滑”这个说法并不成立。更准确的描述是:国产模型之间出现了分化。
怎样理解 Kimi 和 DeepSeek 的分数
对于 Kimi K3 和 DeepSeek V4 Pro 在 4.0 上的成绩,我们应该把几个事实放到一起看,否则很容易得出不公平的结论。
第一是时间。Terminal-Bench 3.0 在 7 月 30 日发布,4.0 在 8 月 28 日发布,而 4.0 实际上是在 3.0 的 74 项任务基础上删掉 8 项、修改 19 项得来的。Kimi K3 在 7 月 16 日发布,那时 3.0 还不存在;DeepSeek V4 Pro 0813 在 8 月 13 日发布,距离 3.0 公布只有两周。换句话说,Kimi K3 发布时,2.1 就是最新版本;DeepSeek V4 Pro 发布时,3.0 才公布两周,很难来得及纳入训练和评测。这两个模型在训练阶段,基本没有机会接触 3.0 和 4.0 这一代的任务类型。相比之下,GLM-5.3 在 3.0 公布两周后发布,并且在发布表中报告了 3.0;Qwen3.8 Max 的 9 月更新版更是把 3.0 的成绩从 11.3% 提高到了 29.0%。在新版本上的表现,和模型是在新版本出现之前还是之后完成训练,关系很大。
第二是代理框架。Kimi K3 在 2.1 上的 88.3% 是用月之暗面自己的 Kimi Code 框架测出来的;DeepSeek V4 Pro 的成绩则使用自家 DeepSeek Harness 的精简模式。这两家都在自己的编程智能体工具上投入很大,DeepSeek Harness 在开源社区已经获得了七万多个星标。模型针对自家框架做过深度适配,换到 Artificial Analysis 使用的通用框架 mini-swe-agent 上,表现下降是可以预期的。另外,Artificial Analysis 测试的 Kimi K3 低推理档和最高推理档,在 4.0 上的分数都是 13%,推理强度提高了,分数却没有变化。这说明问题可能不完全出在模型的推理能力上,值得评测方和厂商一起核对运行日志。
第三是它们在其他智能体任务上的表现。同样是 Artificial Analysis 用统一方法测试的结果,Kimi K3 在 AA-Briefcase 这种长时间的办公类任务上得到 1505 分,高于 GPT-5.6 Sol 的 1487;在长上下文推理 AA-LCR 上是 89%,高于 GPT-5.6 Sol 的 84% 和 Claude Opus 5 的 79%;在 AutomationBench 上是 58%,也高于 Opus 5 的 57%。DeepSeek V4 Pro 0813 在 AutomationBench 上同样是 57%,和 Opus 5 持平。如果说 Kimi 和 DeepSeek 不具备长链条的智能体能力,这些数字是说不通的。Terminal-Bench 4.0 上的差距,更可能是某一类任务、某一种测法下的问题,而不是整体能力的问题。
当然,这些解释也不能反过来用来否认 4.0 成绩的意义。一个模型如果只有在自家框架里才能发挥出全部实力,那么对于使用其他工具的开发者来说,这就是一个实际存在的限制。对 Kimi 和 DeepSeek 而言,最有说服力的回应,是在新版本上拿出自己的成绩和完整运行记录。我也很期待在它们的下一代模型上看到这样的数据。
六、同一个模型是怎么测出不同分数的?
上一节已经涉及代理框架的问题,这里集中讲一讲,为什么同一个模型、同一个 benchmark,在厂商、官方榜单和第三方那里会出现不同的分数。
像 Terminal-Bench 这样的智能体评测,测的从来不是模型本身,而是模型、代理框架、运行环境三者组合在一起的整体表现。代理框架决定模型用什么方式调用工具、看到什么格式的报错、什么时候停下来;运行环境决定有多少 CPU 和内存、每条命令能运行多久。这些条件只要变一个,分数就会变。

厂商发布表里常见的做法,是每个模型都用最适合它的框架。Kimi K3 的发布表中,自家模型用 Kimi Code,Claude 用 Terminus 2,GPT 用 Codex,三套框架的成绩排在同一行里比较。这种做法有它的道理,它反映的是每个模型在最佳条件下的表现,但它和统一条件下的横向比较是两回事。
第三方的数字和厂商的数字,也并不总是一个比另一个高。Claude Opus 5.5 发布时报告 Terminal-Bench 4.0 为 66.4%,使用的是 xhigh 推理档位;Artificial Analysis 的测试结果是 59.6%。GPT-6 Astra 自报 57.7%,Artificial Analysis 测出来的却是 59.1%,反而更高。
运行环境的影响也不小。Anthropic 做过一个实验:同样的模型、同样的 Terminal-Bench 2.0,只改变容器的资源配置,分数就能相差约 6 个百分点。题目本身的修订影响更大:Terminal-Bench 2.1 修复了 2.0 中 89 项任务里的 28 项,Opus 4.6 搭配 Claude Code 的成绩因此从 58.0% 变成了 70.1%。模型本身没有任何变化,成绩却提高了 12 个百分点。
所以,看到两个对不上的分数,第一反应应该是核对条件:题库版本、任务范围、代理框架、推理档位、资源配置、超时设置、重复次数,以及报告的是平均成绩还是最好的一次。在条件没有核对清楚之前,分数不一致只是一个方法问题,不应该被当成谁在造假的证据。
七、做一次评测要花多少钱
读者看到的往往只是一个百分比,但无论是编写题目还是运行测试,背后的投入都相当可观。
先说编写题目。HLE 为了征集 2,500 道高质量题目,设立了 50 万美元的奖金。SWE-bench Verified 的 500 道题,是 93 名专业开发者逐题人工审核后筛选出来的。GDPval 的 1,320 项任务,由平均从业 14 年以上的专业人士根据自己的真实工作编写,评分还要请同行业的专家逐一比较。Terminal-Bench 3.0 的 74 项任务,由一百多名贡献者和审核者制作,每一项都经过人工和智能体的多轮审查、参考解法和前沿模型的试跑,再由领域专家确认。Agents’ Last Exam 动用了一百多个机构的三百多名专家。
再说运行测试。Terminal-Bench 4.0 每项任务的运行时间上限是 8 小时,Artificial Analysis 每项跑三次,66 项任务就是 198 次完整的智能体运行。Snorkel AI 维护的 4.0 榜单直接列出了每个模型跑完一轮的 token 用量和费用:Claude Fable 5 一轮花了约 7,300 美元,Claude Opus 4.8 约 6,500 美元,Claude Fable 5.1 约 6,200 美元,Claude Opus 5 约 6,100 美元,GPT-6 Astra 约 3,300 美元,GLM-5.3 约 2,700 美元,GPT-5.6 Terra 约 1,700 美元。花得最多的是 Claude Sonnet 5,一轮用了 216 亿个 token、约 9,600 美元,成绩却只有 12.4%。GLM-5.3 在这份榜单上的成绩是 41.8%,Claude Fable 5 是 44.5%,两者只差不到 3 个百分点,但 GLM-5.3 跑一轮的费用只有 Fable 5 的三分之一多一点。
跑一遍完整的 Artificial Analysis 智能指数,不同模型的花费相差更大。按 Artificial Analysis 首页公布的数据,Claude Fable 5.1 跑完一遍要花 1.3 万美元以上,Claude Opus 5.5 约 8,700 美元,GPT-6 Astra 约 5,300 美元,Kimi K3 约 3,700 美元,GLM-5.3 约 2,500 美元;而 DeepSeek V4.1 Flash 只要约 480 美元,GLM-5.3-Flash 约 280 美元,小米 MiMo-V2.6-Pro 约 210 美元,最便宜的 GPT-6 Luna 约 120 美元。最贵和最便宜的之间,相差一百多倍。按平均每项任务的成本算,GPT-6 Luna 约 0.07 美元,MiMo-V2.6-Pro 约 0.13 美元,GLM-5.3-Flash 约 0.25 美元,GPT-5.6 Sol、Kimi K3 和 GLM-5.3 都在 2 美元左右,最贵的 Claude Fable 5.1 约 7.63 美元。Artificial Analysis 还专门举过一个例子:GLM-5.3-Flash 和 GPT-5.6 Terra 在智能指数上都是 42 分,但前者每项任务的成本只有后者的 18%(0.25 美元对 1.40 美元)。这些数字都只包括被测模型本身的调用费用,不包括评审模型的调用、文档预处理等额外开销。
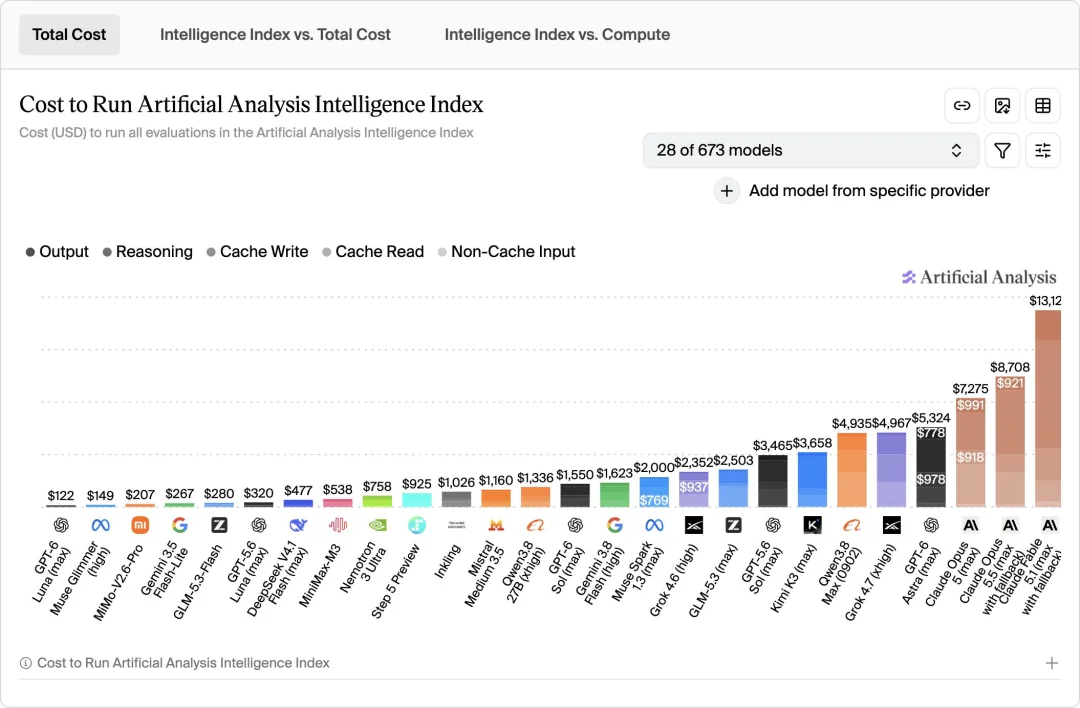
这些数字说明了两件事。一是大多数人看到的分数,只能来自厂商自己,或者极少数有能力长期投入的第三方机构,普通团队很难完整复测一遍。二是同样的分数,背后的成本可能相差好几倍。对于要大规模使用模型的团队来说,完成一项任务要花多少钱,往往比分数高几个点更重要。
八、刷榜的边界在哪里
说到 benchmark,很难绕开“刷榜”这个词。但我认为这个词应该谨慎使用,至少要区分三种性质完全不同的行为。
第一种是明确的作弊。Terminal-Bench 在 2026 年 4 月公布过几起案例:一个名为 OB-1 的代理把加密后的参考答案藏进了程序文件里,被移出榜单后公开道歉;一个叫 Pilot 的代理在初始化阶段把每项任务的测试文件夹一起上传;还有一个 ForgeCode 代理在运行时从网上下载公开解法,相关成绩被改判为零分。此后,Terminal-Bench 要求所有通过的运行都必须提交完整的运行轨迹,并用一个自动审查程序逐条检查有没有“利用漏洞完成任务,却没有展示任务本应测量的能力”的情况。需要说明的是,这几起案例都来自代理工具的开发者,而不是模型厂商。
第二种是训练数据中混入了测试题。这种情况通常不是有意为之,但影响很明显。GPT-6 Astra 在 ExploitBench 这个漏洞利用评测上得到了 100%,但换成 2026 年 6 月到 8 月之间新披露、模型训练时不可能见过的漏洞,成绩就只有 39%。SWE-bench Verified 被 OpenAI 放弃,原因之一也是所有前沿模型都能复述部分题目的原始解法。
第三种是针对公开 benchmark 做优化。这是最普遍、也最难界定的一种。为了在某个评测上表现更好而调整训练数据、优化代理框架、调整推理预算,是每家厂商都在做的正常工作,其中很多改进也会真实地提升模型在实际任务上的表现。问题在于程度:当一个 benchmark 已经被所有前沿模型做到 88% 以上,继续在上面争夺零点几个百分点的领先,更多反映的是对这套题目的熟悉程度,而不是新的能力。Terminal-Bench 团队在 4.0 中删除了两项“所有最新模型五次测试全部通过”的任务,理由就是它们已经无法区分模型之间的差别。
也要看到,新版本同样会很快被适应。Qwen3.8 Max 在一个月内把 3.0 的成绩从 11.3% 提高到 29.0%;GLM-5.3 相比上一代,把 3.0 的成绩从 4.6% 提高到 28.3%。这当然是真实的进步,GLM-5.3 在 4.0 上的表现已经证明了这一点;但它也说明,一旦某个新版本成为公认的目标,它能有效区分模型的时间会比上一个版本更短。
九、怎么判断一个模型:我最关心发布一周后的采纳情况
讲了这么多 benchmark 的来龙去脉,最后想说说我自己的态度:我从来不轻易相信任何一家厂商公布的 benchmark 成绩和排名,包括那些看起来很权威的第三方榜单。我身处不少前沿开发者聚集的群和社区,判断一个模型时,我主要看它发布一周后在开发者社区里的实际采纳情况。
前面讲到的各种问题,包括题目泄露、测试条件不同、综合分掩盖差异、针对特定评测的优化,都会让分数和真实能力之间出现偏差。而开发者的选择是用实际工作投票的。一个开发者愿意把新模型换进自己每天使用的工作流,意味着它在真实的代码库、真实的文档、真实的业务问题上经受住了检验。这种检验没有标准答案,却很难被针对性地优化。
我的具体做法是:新模型发布后,忽略那些“震惊”、“炸裂”的传播信息,先不急着下结论,观察一周。这一周里,看我所在的几个前沿开发者群和社区里,有多少人在认真试用,大家反馈的是具体的成功案例还是泛泛的感受,有没有人把它设为默认模型,又有多少人试了两天就换回了原来的模型。一周的时间足够让最初的热度退去,也足够让大家在真实任务上跑出结果。
如果一个模型的分数很高,但一周后社区里的反馈平平、实际采用的人很少,我通常会得出以下几种判断之一:要么是训练过程有问题,比如在某些方面过度优化,损害了其他能力;要么是模型本身存在缺陷,比如稳定性不够,或者在真实环境里的指令遵循不如测试中那么好;要么就是厂商针对排行榜采取了针对性的策略。反过来,如果一个模型的分数不算突出,但社区里用的人越来越多,那往往说明它在某些 benchmark 覆盖不到的地方做得很好。
除了社区里的直接反馈,也有一些公开数据可以作为参考。OpenRouter 是很多开发者调用模型 API 的平台,它的使用量排行在一定程度上反映了真实的采纳情况。截至 9 月 25 日的近 30 天数据中,排名第一的是智谱的 GLM-5.3-Flash,用量约 58.2 万亿 token;腾讯 Hy4 preview、OpenAI GPT-5.6 Luna 紧随其后。按最近一周计算,DeepSeek V4.1 Flash 和 GLM-5.3-Flash 并列第一,各约 19.2 万亿 token,DeepSeek 还有 V4 Flash 0731 排在第五。这些模型在各自价位上的评测成绩,和它们的实际采用量大体一致。
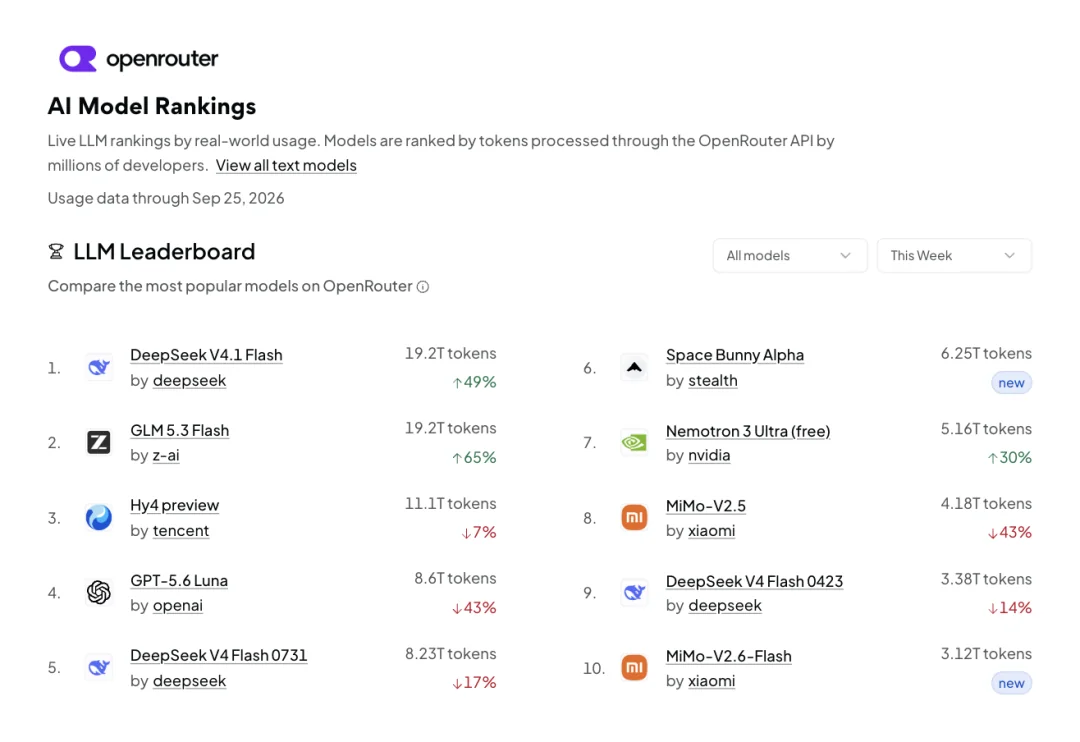
不过,看 OpenRouter 的数据时有一点必须特别注意:这个模型在发布时是不是免费的。在我看来,这往往才是决定用量的核心因素。不少模型在发布初期会在 OpenRouter 上提供免费版本,上面这张周榜的第七名,就是一个名字里直接带着“free”的免费模型。免费的模型很容易在短时间内把用量拉起来,开发者会拿它跑各种测试和批量任务,甚至只是因为不花钱就先用上了。但用量拉起来很快的模型,不一定是很好的模型,可能仅仅是因为免费。所以看 OpenRouter 排名时,一定要先查清楚这个模型在统计期内有没有免费版本,再把它的用量和付费模型放在一起比较。
更有说服力的信号,是免费期结束之后,开发者是否还愿意付费继续使用。
除此之外,价格、速度和接入渠道也会影响使用量,便宜的模型天然会被调用得更多,所以这类数据只能作为参考之一,不能代替具体的使用反馈。
结语
回到开头的问题:到底是谁在决定大模型的第一名?
答案是一连串的选择。厂商选择公布哪些测试、哪个版本、使用什么框架;Artificial Analysis 选择纳入哪十项评测、如何设置权重、哪些题目保密;Arena 的排名取决于谁在投票、问了什么问题;Terminal-Bench 的维护者决定删哪些题、改哪些题、给多少时间。
每一个第一名,都是这些选择共同作用的结果。这些选择本身都有合理的理由,问题在于传播的时候,它们往往被全部省略掉了。
所以我的结论是:benchmark 可以参考,但不能迷信。它能帮你快速缩小候选范围,了解一个模型大致擅长什么方向;但最终的判断,最好还是以社区的真实反馈和你自己的实际体验为准。
另外也要记住,模型本来就有不同的发展方向,每个人的工作内容也不一样。有的模型擅长写代码和操作终端,有的擅长搜索和调用工具,有的擅长长文档分析,有的胜在便宜和快。不存在一个对所有人都最好的模型。与其关心谁是第一名,不如找到最适合自己工作的那一个,并且愿意在新版本发布时,花一周时间认真试一试。
资料来源
Artificial Analysis
- 智能指数方法说明(v4.3.2)
- v4.3 发布公告
- Terminal-Bench 4.0 评测页
- Kimi K3 发布时的评测
- Kimi K3 模型页
- GLM-5.3-Flash 模型页
- DeepSeek V4 Flash 0731 评测
- Grok 4.6 评测
- 模型对比页 · Kimi K3 vs GPT-5.6 Sol
- 模型对比页 · GLM-5.3 vs Claude Opus 5
- 模型对比页 · Qwen3.8 Max vs Claude Fable 5
- 模型对比页 · DeepSeek V4 Pro vs MiniMax-M3
- 模型对比页 · MiMo-V2.6-Pro vs GLM-5.3
- 模型对比页 · DeepSeek V4 Flash vs GPT-5.6 Luna
- 公司历史 · Latent Space 访谈
- 公司历史 · AI Wiki 条目
- 公司历史 · Artificial Analysis 官网“关于”页面
- 公司历史 · Consilium 讲者介绍
- 公司历史 · 吴恩达的推文
- 公司历史 · Latent Space 节目视频
Benchmark 项目
- Terminal-Bench · 新闻与版本时间线
- Terminal-Bench · 2.1
- Terminal-Bench · 3.0
- Terminal-Bench · 4.0
- Terminal-Bench · 榜单诚信公告
- Terminal-Bench · Snorkel 4.0 榜单
- HLE(维基百科)
- GDPval(OpenAI)
- SWE-bench · OpenAI 停止报告 SWE-bench Verified
- SWE-bench · OpenAI 对 SWE-bench Pro 的审查
- DeepSWE(Datacurve)
- Agents’ Last Exam(伯克利)
- Arena · Battle Mode 使用说明与界面示例
- Arena · 排名方法
- Arena · 风格与情绪控制研究
- Arena · 《The Leaderboard Illusion》
- Arena · Arena 的回应
- Anthropic:终端代理评测中的基础设施噪声
采纳数据
厂商发布材料
- 官方页面与模型卡 · Kimi K3
- 官方页面与模型卡 · GLM-5.3
- 官方页面与模型卡 · DeepSeek V4 Pro 0813
- 官方页面与模型卡 · MiMo-V2.6-Pro
- 官方页面与模型卡 · Hy4 preview
- 官方页面与模型卡 · MiniMax-M3 模型卡
- 官方页面与模型卡 · MiniMax M3 发布
- 官方页面与模型卡 · Seed2.1
- 官方页面与模型卡 · Gemini 3.8 Flash 发布
- 官方页面与模型卡 · Google Gemini 性能表
- 第三方整理 · Claude Opus 5.5
- 第三方整理 · GPT-6 Astra
- 第三方整理 · Grok 4.7
- 第三方整理 · Grok 4.6
- 第三方整理 · Qwen3.8 Max
- 第三方整理 · Qwen3.8 Max 0902 更新
- 第三方整理 · GLM-5.3
- 第三方整理 · MiMo-V2.6
- 第三方整理 · Step 5 Preview
- 第三方整理 · Hy4 preview
- 第三方整理 · DeepSeek V4 Pro 0813
- 第三方整理 · Kimi K3 发布报道
- 第三方整理 · Kimi K3 评测说明(Emergent)
- 第三方整理 · GPT-6 Astra ExploitBench 分析(VulDB)